RAG Adalah: Cara Perusahaan Membuat AI Menjawab dari Dokumen Internal Tanpa Membocorkan Data
RAG (retrieval-augmented generation) adalah teknik yang membuat AI mencari potongan dokumen yang relevan lebih dulu, lalu menyusun jawaban hanya dari potongan itu beserta rujukan sumbernya. Model tidak perlu dilatih ulang dengan data perusahaan, sehingga dokumen tetap berada di sistem Anda. Bocor atau tidaknya data ditentukan oleh dua keputusan desain: siapa boleh mengambil dokumen apa, dan di mana dokumen itu diproses.
Apa Itu RAG, dalam Bahasa Bisnis
Bayangkan karyawan baru yang cerdas tetapi belum pernah membaca SOP perusahaan Anda. Ditanya soal prosedur pengadaan, ia akan menebak. RAG memberinya akses ke lemari arsip yang tepat sebelum menjawab, lalu memintanya menunjukkan halaman yang ia kutip. Model bahasa besar (LLM) berada di posisi yang sama: ia tidak tahu isi dokumen internal Anda.
Istilah RAG berasal dari makalah Patrick Lewis dan rekan-rekan yang diunggah ke arXiv pada 22 Mei 2020. Mereka memadukan pengetahuan di dalam bobot model dengan indeks vektor Wikipedia, karena model saja sulit menunjukkan asal jawabannya dan sulit diperbarui. AWS kini merumuskannya secara praktis: RAG membuat LLM merujuk basis pengetahuan otoritatif di luar data latihnya sebelum menjawab, tanpa melatih ulang model.
Survei Menlo Ventures yang terbit 9 Desember 2025 terhadap 495 pengambil keputusan AI di perusahaan Amerika Serikat mencatat prompt design sebagai teknik kustomisasi paling umum, disusul RAG, sementara fine-tuning masih terbatas pada tim yang paling maju. Survei Unisphere Research yang dimuat DBTA pada 9 Januari 2025 terhadap 382 eksekutif dan manajer, mayoritas di Amerika Utara, menemukan 29% responden pengguna LLM sudah memiliki atau sedang membangun RAG.
Cara Kerja RAG, Langkah demi Langkah
RAG berjalan dalam dua fase: persiapan, yang diulang setiap ada dokumen baru, dan menjawab, setiap kali pengguna bertanya.
Ingest. Dokumen ditarik dari file server, SharePoint, sistem manajemen dokumen, atau database, lalu teksnya diekstrak. PDF hasil pindaian butuh OCR (pengenalan karakter optik).
Chunking. Dokumen dipecah menjadi potongan, umumnya tidak lebih dari beberapa ratus token menurut Anthropic. Ukuran, batas, dan tumpang-tindih potongan memengaruhi kualitas pencarian.
Embedding. Setiap potongan diubah menjadi deretan angka (vektor) yang mewakili maknanya, sehingga teks bermakna mirip bisa ditemukan walau kata-katanya berbeda.
Vector database. Vektor disimpan di basis data yang dirancang untuk mencari kemiripan makna, bersama metadata seperti judul, tanggal berlaku, unit pemilik, dan label akses.
Retrieval. Pertanyaan pengguna juga diubah menjadi vektor, lalu sistem mencari potongan yang paling mirip. Microsoft dan Google sama-sama menyediakan hybrid search, gabungan pencarian vektor dan kata kunci, karena nomor pasal atau kode produk mudah terlewat oleh pencarian makna saja.
Re-ranking. Model penilai mengurutkan ulang kandidat dan hanya meneruskan yang paling relevan. Dalam uji Anthropic yang dipublikasikan 19 September 2024, embedding dan pencarian kata kunci yang diperkaya konteks menurunkan kegagalan retrieval 49%, dan 67% setelah ditambah re-ranking.
Generation dengan sitasi. LLM menyusun jawaban dari potongan terpilih dan menyertakan rujukannya, sehingga pengguna bisa memeriksa sendiri dokumen sumbernya.
Satu langkah sering dilupakan: pembaruan. Tanpa penyegaran dokumen dan embedding, sistem akan mengutip kebijakan yang sudah dicabut.
RAG vs Fine-Tuning vs Long-Context Prompting
Ada tiga cara memberi AI pengetahuan tentang perusahaan Anda. Fine-tuning melatih lanjut model dengan contoh. Long-context prompting memasukkan seluruh dokumen ke prompt. RAG hanya mengambil potongan yang relevan.
Aspek | RAG | Fine-tuning | Long-context prompting |
|---|---|---|---|
Paling cocok untuk | Ribuan dokumen yang sering berubah dan butuh sitasi | Gaya, nada, format keluaran, pemilihan tool | Kumpulan dokumen kecil, di bawah sekitar 500 halaman |
Biaya | Sedang: pipeline data, indeks, integrasi izin, evaluasi | Tinggi: data latih, pelatihan berulang, hosting model | Rendah di awal, naik seiring panjang dokumen per pertanyaan |
Kesegaran data | Segar selama indeks diperbarui | Beku sampai model dilatih ulang | Segar, dokumen dikirim ulang setiap kali |
Upaya | Rekayasa data dan pencarian | Rekayasa ML, data berlabel, siklus uji | Paling ringan |
Kontrol akses per pengguna | Bisa per dokumen | Sulit, pengetahuan melebur ke model | Bisa, dokumen dipilih per permintaan |
Panduan Microsoft yang diperbarui 29 Oktober 2026 menyebut fine-tuning menambah biaya pelatihan dan hosting, tidak menjamin hasil, dan tidak menggantikan retrieval untuk informasi terkini. Anthropic menyarankan basis pengetahuan di bawah 200.000 token, sekitar 500 halaman, cukup dimasukkan utuh ke prompt, dengan prompt caching yang bisa memangkas biaya hingga 90%. Untuk volume lebih besar, Google Cloud mencatat RAG mengurangi jumlah token sehingga menghemat waktu dan biaya.
Yang Membedakan RAG Enterprise dari Demo
Demo RAG bisa dibuat dalam sehari: semua file masuk satu indeks, sambungkan ke LLM, selesai. Masalahnya muncul ketika staf penjualan bertanya soal struktur gaji dan sistem menjawab dari dokumen HR.
Retrieval harus mengikuti izin akses
Aturannya: pengguna hanya boleh mengambil dokumen yang memang boleh ia buka di sistem asalnya. Filter ini diterapkan di tahap retrieval, sebelum potongan dokumen sampai ke LLM, bukan dengan menyuruh model merahasiakan isi tertentu.
OWASP Top 10 for LLM Applications 2025 memasukkan risiko ini sebagai LLM08, Vector and Embedding Weaknesses: kontrol akses yang lemah, kebocoran antarkelompok di vector database bersama, hingga embedding inversion, yaitu merekonstruksi teks asli dari vektornya. Mitigasinya: penyimpanan vektor yang sadar izin, partisi data yang ketat, klasifikasi data, dan log retrieval yang tidak bisa diubah.
Dokumentasi Azure AI Search per 17 September 2026 mencatat security filter sudah generally available, sementara pewarisan ACL, label sensitivitas Purview, dan izin SharePoint masih preview. Perubahan izin di sistem sumber juga baru berlaku setelah metadata disinkronkan ke indeks, jadi tetapkan seberapa cepat karyawan yang pindah unit kehilangan akses lamanya.
Dokumen bisa membawa perintah tersembunyi
OWASP menempatkan prompt injection di posisi LLM01:2025, termasuk varian tidak langsung: instruksi berbahaya masuk lewat konten eksternal seperti situs atau file. OWASP mencatat RAG tidak sepenuhnya menutup celah ini. Contohnya, penyerang mengubah dokumen di repositori RAG sehingga jawaban yang mengambil dokumen itu ikut menyimpang, atau CV berisi teks putih di latar putih yang menyuruh sistem merekomendasikan pelamarnya.
Pengamanannya: deteksi teks tersembunyi sebelum dokumen masuk indeks, beri label konten yang tidak tepercaya, batasi hak akses sistem, dan wajibkan persetujuan manusia untuk tindakan berisiko. Poin terakhir makin penting ketika RAG menjadi bagian dari agen AI yang bisa mengirim surel atau mengubah data, seperti di artikel use case agentic AI di Indonesia.
Kualitas harus diukur, bukan dirasakan
Evaluasi dilakukan di dua lapis. Untuk retrieval, framework sumber terbuka Ragas memakai context recall: porsi informasi rujukan yang berhasil ditemukan. Untuk jawaban, metrik faithfulness menghitung porsi klaim yang didukung konteks yang diambil. Google Cloud memakai metrik serupa, groundedness, dan menyarankan menetapkan baseline dulu sebelum menyetel pencarian, data sumber, atau chunking.
Studi tim Stanford di Journal of Empirical Legal Studies (2025) menemukan alat riset hukum komersial berbasis RAG masih berhalusinasi pada 17% hingga 33% jawaban. RAG mengurangi halusinasi, tetapi tidak menghapusnya. Siapkan pertanyaan uji beserta jawaban rujukan dari pemilik proses, dan jalankan ulang setiap kali dokumen atau konfigurasi berubah.
Penyebab RAG Gagal di Lapangan
Dalam survei Unisphere Research tadi, 71% responden menyebut kualitas data sebagai tantangan utama. Di proyek RAG, bentuknya biasanya seperti ini:
PDF hasil pindaian. Tanpa OCR, tidak ada teks untuk dicari. OCR yang buruk menghasilkan potongan rusak, dan sistem tetap menjawab dengan yakin.
Tabel. Chunking yang memotong tabel memisahkan angka dari judul kolomnya. Tabel tarif dan matriks kewenangan perlu parser yang memahami tata letak.
Dokumen kedaluwarsa dan duplikat. Kalau SOP lama dan baru sama-sama terindeks, sistem bisa mengutip yang sudah dicabut. Setiap dokumen butuh pemilik, tanggal berlaku, dan status.
Campuran bahasa Indonesia dan Inggris. Kebijakan berbahasa Indonesia, manual vendor berbahasa Inggris, dan pertanyaan penuh singkatan internal. Uji model embedding multibahasa di dokumen Anda sendiri; Azure AI Search, misalnya, menyediakan lebih dari 50 language analyzer dan synonym map untuk istilah yang berbeda.
Potongan kehilangan konteks. Anthropic mencontohkan potongan yang menyebut pendapatan naik 3% tanpa nama perusahaan dan periodenya. Menambahkan judul dokumen dan nama bagian ke setiap potongan adalah perbaikan yang murah.
Di Mana Data Diproses: Luar Negeri, Lokal, atau On-Premise
Sistem RAG punya setidaknya tiga titik pemrosesan: model embedding, vector database, dan LLM penulis jawaban. Yang sering terlewat, membuat embedding lewat API berarti mengirim isi dokumen ke penyedia model tersebut.
Opsi | Kelebihan | Yang perlu dicek |
|---|---|---|
API model global | Model terbaru, cepat dimulai, tanpa infrastruktur | Lokasi pemrosesan, retensi, dasar transfer ke luar negeri |
Penyedia cloud atau inferensi di Indonesia | Data diproses di dalam negeri, bayar per pemakaian | Katalog model, kualitas bahasa Indonesia, SLA |
On-premise atau private deployment | Kendali penuh atas dokumen, model, dan log | Investasi GPU, tim operasional, pembaruan model |
PP 33/2026, aturan pelaksana UU Pelindungan Data Pribadi, ditetapkan 16 Juli 2026 dan berlaku 16 Januari 2027. Menurut ringkasan RSM Indonesia, Pasal 165 menetapkan urutan dasar transfer ke luar negeri: negara tujuan dengan pelindungan setara atau lebih tinggi, lalu pengaman yang memadai dan mengikat, dan baru kemudian persetujuan subjek data. Mekanisme negara setara dan klausul kontrak standar masih menunggu Lembaga PDP. PP ini juga menyebut teknologi baru, termasuk AI dan machine learning, sebagai pemicu DPIA (penilaian dampak pelindungan data). Rinciannya ada di artikel PP 33/2026 dan proyek AI Anda. Artikel ini bukan nasihat hukum; konfirmasikan dengan konsultan hukum Anda.
Kalau dokumen memuat data pribadi pelanggan atau karyawan, pemrosesan di dalam negeri layak dihitung serius, lewat penyedia inferensi lokal atau server sendiri bila volumenya besar dan stabil (lihat hitungan sewa GPU vs beli server). Namun pemrosesan lokal tidak otomatis patuh: dasar pemrosesan, retensi, dan keamanan tetap harus dinilai.
Use Case yang Realistis, dan Kapan RAG Bukan Jawabannya
RAG paling bernilai ketika jawabannya ada di dokumen, dokumennya banyak, dan penanya butuh sumber untuk dipertanggungjawabkan. Lima use case yang realistis untuk perusahaan di Indonesia:
Asisten SOP dan kebijakan internal. Jawaban soal pengadaan atau perjalanan dinas, lengkap dengan nomor dokumen.
Pencarian regulasi dan kepatuhan. POJK, peraturan menteri, dan kebijakan internal ditelusuri sekaligus dengan rujukan pasal. Keputusan akhir tetap di reviewer hukum.
Kebijakan HR. Cuti, benefit, dan lembur, dengan izin akses per level jabatan supaya dokumen remunerasi tidak terbuka untuk semua.
Basis pengetahuan customer service. Agen mendapat draf jawaban dari katalog produk dan syarat layanan terbaru, lalu memeriksanya.
Manual teknik dan engineering. Prosedur perawatan dan kode gangguan dari manual mesin, yang biasanya penuh tabel dan hasil pindaian.
Sebaliknya, RAG bukan jawaban bila:
Dokumennya sedikit. Di bawah sekitar 500 halaman, long-context prompting lebih sederhana.
Pertanyaannya hitungan atas data terstruktur. Penjualan kuartal ketiga per cabang dijawab lewat query ke database atau BI, bukan pencarian dokumen.
Yang dibutuhkan gaya atau format. Prompt yang lebih baik atau fine-tuning lebih tepat.
Dokumen sumbernya belum rapi. Tanpa pemilik dan versi yang jelas, RAG hanya mempercepat penyebaran informasi yang salah.
Keputusannya harus deterministik. Persetujuan kredit mengikuti aturan bisnis yang bisa diaudit. RAG boleh membantu mencari dasar aturannya, bukan memutuskan.
Seberapa siap data Anda untuk RAG?
AI Readiness Scorecard berisi 6 pertanyaan, selesai sekitar 2 menit, dan memberi skor kesiapan, analisis per dimensi, serta langkah berikutnya. Tanpa daftar.
Cek Kesiapan AI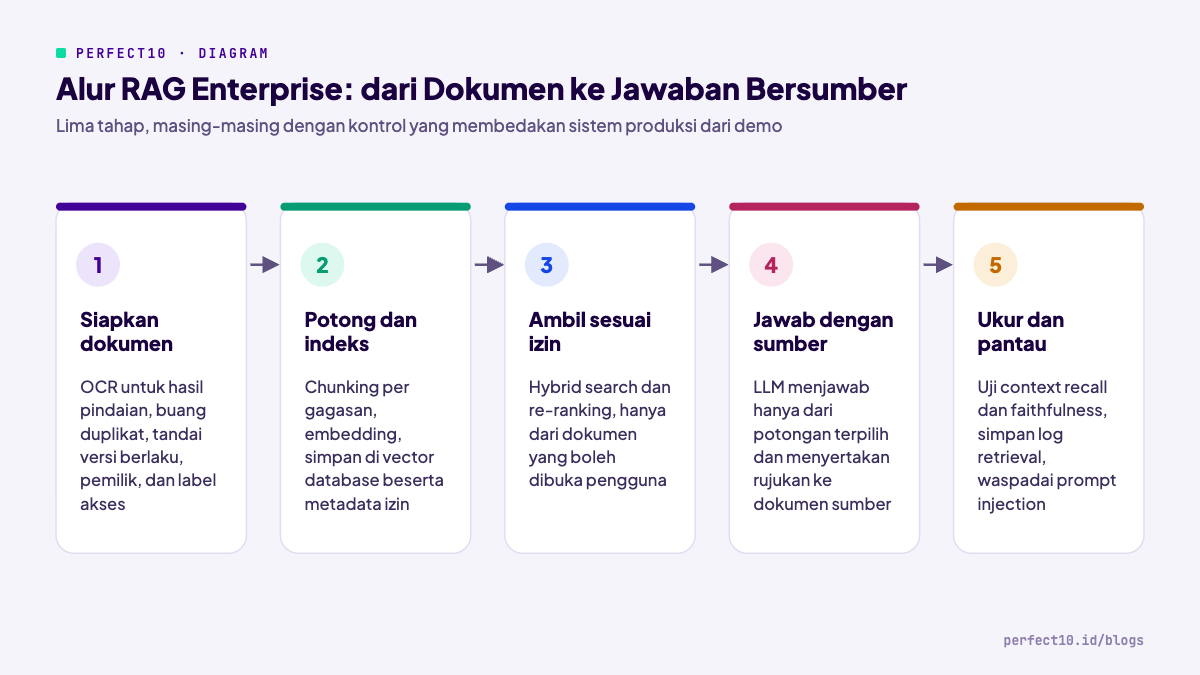
Pertanyaan yang Sering Diajukan
RAG adalah apa dalam AI?
RAG adalah teknik yang membuat AI mencari dokumen yang relevan lebih dulu, lalu menjawab berdasarkan dokumen itu beserta sumbernya. Istilahnya berasal dari makalah Lewis dan rekan-rekan pada 2020, dan kini menjadi cara umum menghubungkan LLM dengan pengetahuan internal perusahaan tanpa melatih ulang model.
Apa bedanya RAG dan fine-tuning?
RAG memberi model akses ke dokumen saat menjawab, sehingga informasinya bisa diperbarui kapan saja dan disertai sitasi. Fine-tuning melatih lanjut model untuk mengubah gaya atau perilakunya, dan menurut Microsoft tidak menggantikan retrieval untuk informasi terkini.
Apa itu vector database, dan apakah wajib untuk RAG?
Vector database menyimpan potongan dokumen sebagai vektor sehingga bisa dicari berdasarkan kemiripan makna. Komponen ini paling umum, tetapi database relasional dan knowledge graph juga dipakai untuk RAG, dan untuk dokumen yang sedikit retrieval mungkin tidak diperlukan.
Apakah RAG bisa membocorkan data perusahaan?
Bisa, bila retrieval tidak mengikuti izin akses atau dokumen diproses di layanan yang tidak sesuai ketentuan data Anda. OWASP memasukkan risiko ini sebagai LLM08:2025, dengan mitigasi utama penyimpanan vektor yang sadar izin, partisi data, dan log retrieval.
Apakah RAG menghilangkan halusinasi AI?
Tidak sepenuhnya. Studi tim Stanford (2025) menemukan alat riset hukum berbasis RAG masih berhalusinasi pada 17% hingga 33% jawaban, sehingga evaluasi berkala dan tinjauan manusia tetap diperlukan.
Sebelum memilih arsitektur, hitung dulu berapa jam kerja tim Anda yang habis untuk mencari dan menjawab dari dokumen.
Berapa nilai otomatisasi untuk tim Anda?
Masukkan ukuran tim, rentang gaji, dan use case yang relevan. AI ROI Calculator langsung memperkirakan penghematan tahunan, persentase ROI, dan masa balik modal, tanpa daftar.
Coba AI ROI CalculatorKalau Anda ingin memetakan dokumen mana yang layak masuk RAG, siapa boleh mengakses apa, dan di mana sebaiknya data diproses, tim PERFECT10 menyediakan sesi discovery 60 menit tanpa biaya. Jadwalkan sesi discovery.
Baca juga:
PP 33/2026 dan Proyek AI Anda: 7 Hal yang Harus Beres Sebelum 16 Januari 2027
Cara Memilih AI Implementation Partner: 12 Pertanyaan Sebelum Tanda Tangan Kontrak
Init-6 Danai Netra Runtime: Sinyal Baru untuk Inferensi AI di Indonesia
Sumber
AWS, What is RAG (Retrieval-Augmented Generation)?, diperbarui Oktober 2026
Google Cloud, What is Retrieval-Augmented Generation (RAG)?, diakses 1 November 2026
Microsoft Learn, Retrieval-augmented generation in Azure AI Search, diperbarui 4 Agustus 2026
Microsoft Learn, Document-level access control in Azure AI Search, diperbarui 17 September 2026
Microsoft Learn, Fine-tuning in Microsoft Foundry, diperbarui 29 Oktober 2026
Anthropic, Introducing Contextual Retrieval, 19 September 2024
OWASP Gen AI Security Project, LLM01:2025 Prompt Injection, diperbarui 17 April 2025
OWASP Gen AI Security Project, LLM08:2025 Vector and Embedding Weaknesses, diperbarui 28 April 2025
Ragas, dokumentasi metrik evaluasi RAG (faithfulness, context recall), diperbarui 11 Desember 2025
Menlo Ventures, 2025: The State of Generative AI in the Enterprise, 9 Desember 2025